
Revisitar el Sistema de Producción Toyota en la era de los agentes de programación basados en IA
A medida que los agentes de programación basados en IA desplazan el cuello de botella en el desarrollo de software de la fase de producción a la de verificación, el autor sostiene que los principios del TPS pueden contribuir a crear sistemas en los que los defectos no puedan pasar inadvertidos.
El desarrollo de software ha tomado prestados muchos elementos —una cantidad sorprendente— del ámbito de la manufactura. No me refiero a la manufactura en el sentido de «pongamos a los programadores en una cadena de montaje»; afortunadamente, ya hemos probado suficientes variantes de esa idea.
Me refiero a algo más interesante.
Algunas de las ideas más influyentes en el desarrollo de software moderno surgieron al observar cómo Toyota transformó la manufactura. El desarrollo de software Lean, kanban, la limitación del trabajo en curso, la reducción de desperdicios, la optimización del flujo, la mejora continua y los sistemas pull: muchas de estas ideas tienen un origen que se remonta a la manufactura.
Y en el centro de esta historia se encuentra el Sistema de Producción de Toyota (TPS).
Toyota define el TPS a partir de dos pilares: Jidoka y Just-in-Time. Jidoka podría describirse como "automatización con un toque humano": cuando se detecta una anomalía, el proceso se detiene en lugar de seguir produciendo elementos defectuosos. El concepto Just-in-Time consiste en producir lo que se necesita, cuando se necesita y en la cantidad necesaria.
Estas ideas se desarrollaron para un mundo de productos físicos. Sin embargo, estamos entrando en una nueva etapa en la que el desarrollo de software está cambiando drásticamente; y, en esta ocasión, la analogía con la manufactura podría resultar útil por una razón completamente distinta.
El cuello de botella en el desarrollo de software se está desplazando.
Durante gran parte de la historia del desarrollo de software, crear software ha sido costoso. Escribir código requería tiempo; comprender una base de código, también. Las tareas de prueba, depuración y revisión de código consumían tiempo. Dado que los desarrolladores son seres humanos, todas estas actividades estaban limitadas por la cantidad de personas disponibles para llevarlas a cabo.
En torno a esta limitación, construimos diversos procesos:
- Entornos de desarrollo integrado (IDE) para agilizar la escritura y la navegación por el código.
- Lenguajes y frameworks para facilitar la expresión del código.
- Sistemas de integración continua (CI) para compilar y probar los cambios de forma automática.
- Metodologías ágiles y kanban para mejorar los ciclos de retroalimentación y el flujo de trabajo.
Entonces, aparecieron los agentes de programación. De repente, el costo de producir código cambió. Un agente puede leer una base de código, modificar decenas de archivos, ejecutar comandos, inspeccionar los resultados de las pruebas, realizar nuevos ajustes y repetir el proceso sin necesidad de esperar a que un humano escriba cada línea.
La capacidad de producción en el desarrollo de software puede aumentar de manera espectacular. Pero si un agente puede generar cambios más rápido de lo que nos toma verificar que dichos cambios son correctos, hemos creado un nuevo cuello de botella: la verificación.
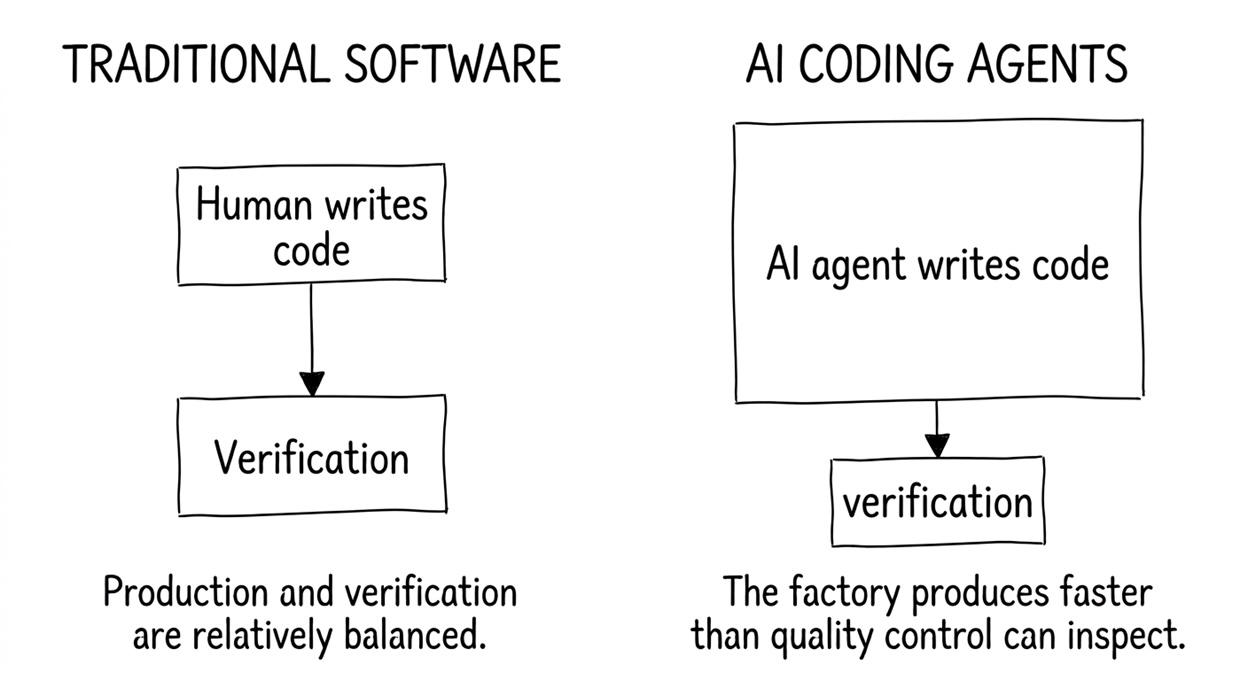
Se trata de un problema de fabricación, un ámbito que lleva mucho tiempo reflexionando sobre estas cuestiones.
Una nueva mirada al entorno de producción
La solución no consiste en copiar a ciegas el modelo de Toyota. El software no implica inventario físico, ni cadenas de montaje materiales, ni camiones esperando piezas. Sin embargo, los desafíos subyacentes son idénticos:
- ¿Cómo prevenir los defectos?
- ¿Cómo detectar los problemas lo antes posible?
- ¿Qué debe suceder cuando surge una anomalía?
- ¿Qué cantidad de trabajo inacabado es admisible?
- ¿Cómo mejorar el proceso de producción en lugar de limitarse a inspeccionar el resultado final?
- ¿Cómo aumentar la velocidad de producción sin incrementar la tasa de defectos que llegan a filtrarse?
Estas son, precisamente, las cuestiones que dieron lugar a las prácticas modernas de calidad en la fabricación.
Jidoka y el cordón Andon en el software
De todos los conceptos de Toyota, el Jidoka es el más relevante para los agentes de programación basados en IA. La idea fundamental es sencilla: si una máquina detecta una anomalía, se detiene. El objetivo no es simplemente identificar productos defectuosos al final de la cadena, sino evitar que se sigan produciendo, integrando la calidad directamente en el proceso.
Un sistema automatizado convencional funciona de la siguiente manera:
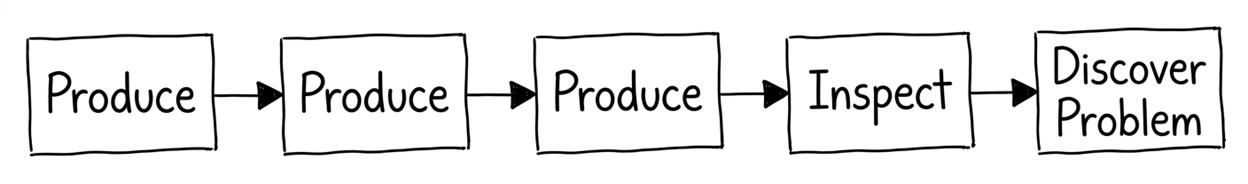
El Jidoka propone un enfoque distinto:
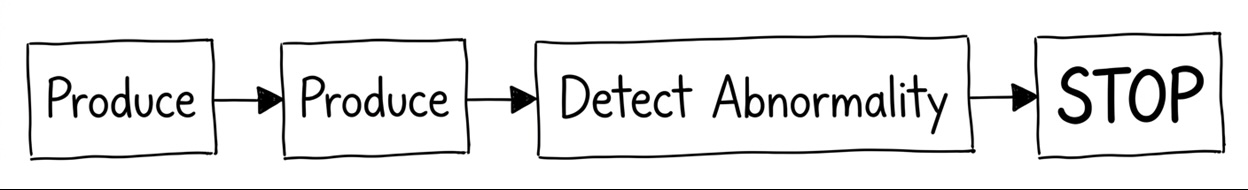
Diagrama de flujo del Jidoka
Imaginemos a un agente trabajando en una tarea. Este modifica varios archivos de forma secuencial. Las pruebas se superan correctamente hasta que un invariante importante —una condición que debe mantenerse siempre verdadera— deja de cumplirse. Un agente poco sofisticado seguiría intentando aplicar correcciones al azar:
"La prueba ha fallado. Probaré con otro enfoque... y con otro... y con otro más".
Al hacerlo, acumula una enorme cantidad de estado no verificado. Un agente inspirado en el concepto de *Jidoka* actúa de manera deliberada. Aquí es donde cobra interés el principio *lean* del «trabajo estandarizado»: el agente debe operar dentro de restricciones claramente definidas —qué debe permanecer inalterable, qué debe verificarse y cuándo debe detenerse el trabajo.
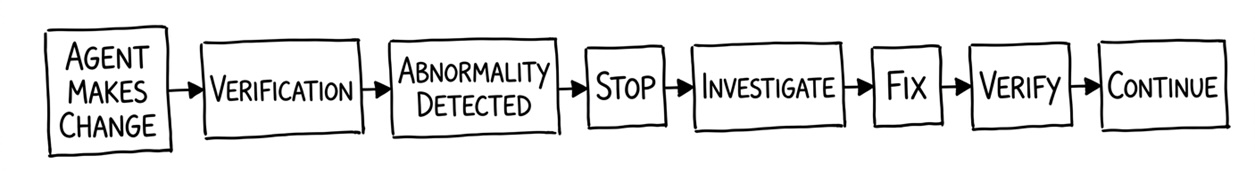
El agente no solo debe ser capaz de detenerse; debe estar diseñado para hacerlo.
El cordón Andon
Toyota utiliza una señal Andon para hacer visibles las anomalías y dirigir la atención inmediata al punto donde se produce el fallo. Aunque el software ya emplea señales —como fallos en procesos de integración continua (CI) o alertas de producción—, los agentes de IA nos permiten convertir cualquier invariante en un cordón Andon:
- Un error de tipo que provocaría el bloqueo del programa.
- Un cambio que rompe una interfaz acordada entre dos servicios.
- La violación de una regla de seguridad.
- Un cambio en la base de datos que destruiría datos existentes.
- Una caída en el porcentaje de código cubierto por pruebas.
- El incumplimiento de un límite de rendimiento.
La distinción básica es que la señal no es solo una advertencia pasiva que aparece en un panel de control; es un mecanismo de control activo. El agente pierde el permiso para continuar hasta que la anomalía se resuelve.
Al igual que ocurre con una señal Andon en una línea de producción de Toyota, detener el proceso es solo el principio. Alguien debe investigar la anomalía, determinar si el problema reside en el producto o en el proceso, y decidir qué pasos seguir a continuación. En un sistema basado en agentes, este rol recae cada vez más en el ingeniero que supervisa el sistema de producción, en lugar de en la persona que revisa cada línea de código de forma individual.
Poka-yoke: blindar el entorno frente a errores
El poka-yoke se centra en el uso de mecanismos a prueba de fallos para evitar por completo los errores simples. Solemos plantear la verificación de software de la siguiente manera:
«¿Cómo podemos detectar si el agente ha cometido un error?»
Una pregunta mucho mejor sería:
«¿Podemos hacer que sea imposible para el agente cometer este error en particular?»
Si un agente necesita modificar una base de datos, otorgarle acceso sin restricciones implica depender de pruebas a posteriori para detectar operaciones peligrosas. Diseñar un entorno poka-yoke modifica la interfaz:
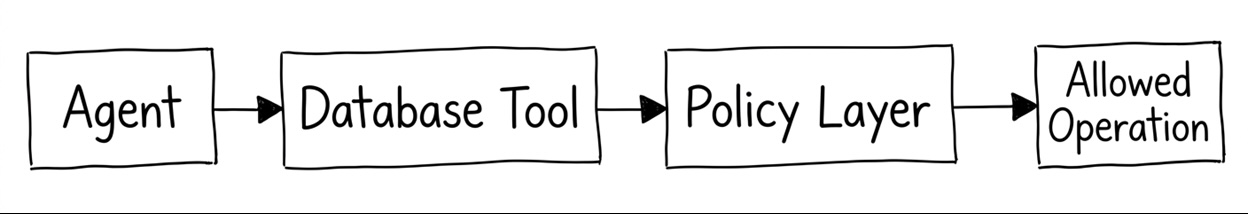
Una operación destructiva, sencillamente, no está disponible a través de la interfaz. El agente no puede ejecutarla porque dicha capacidad no existe en ese contexto.
Esto se aplica por igual a la instalación de dependencias (añadir bibliotecas de software externas), al acceso a secretos (credenciales y otra información confidencial), a las migraciones de esquemas (cambios en la estructura de una base de datos) y a las modificaciones de permisos.
Principio básico de diseño: no intentes enseñar al agente a no cometer errores si puedes diseñar el sistema de tal forma que el error sea imposible de cometer.
Calidad en la fuente y límites al WIP ante la incertidumbre
Si un agente realiza una docena de cambios antes de proceder a su verificación, se genera un espacio de búsqueda enorme cuando, inevitablemente, surge un fallo. Diagnosticar qué suposición resultó errónea se vuelve exponencialmente más difícil a medida que se acumula trabajo sin verificar.
Los agentes de IA dedicados a la programación requieren un concepto similar a los límites de WIP. En lugar de realizar un seguimiento de los tickets abiertos, deberíamos limitar la cantidad de cambios sin verificar presentes en el sistema.
Esto conecta directamente con la filosofía Just-in-Time. Si el Jidoka nos indica cuándo debemos detenernos, el Just-in-Time nos señala cuánto trabajo debería permitirse introducir en el sistema desde un principio. ¿Por qué habría de generar un agente más cambios de los que el sistema de verificación es capaz de procesar? La clave no es maximizar la producción, sino establecer un sistema basado en el pull, donde el nuevo trabajo solo se introduce a medida que existe capacidad de verificación disponible.
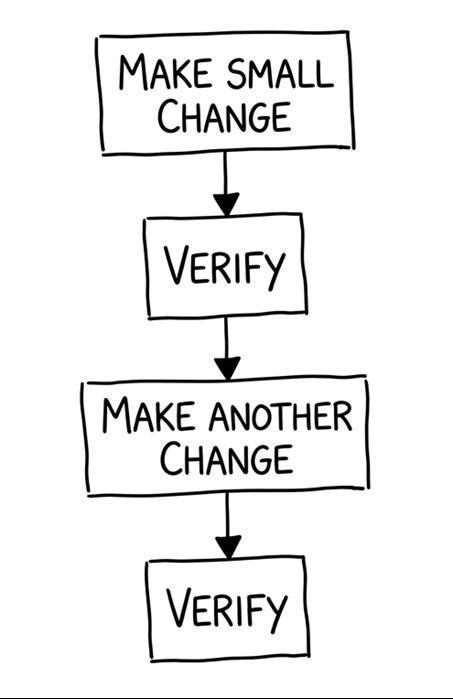
Consideremos un agente que opera con un presupuesto de «deuda de verificación»: una métrica sencilla que indica cuántos cambios sin verificar contiene el sistema en un momento dado.
- Invariante no comprobada = +1
- Dependencia no validada = +1
- Integración no verificada = +1
Las cifras exactas son menos importantes que el principio subyacente: a medida que se acumula trabajo sin verificar, la libertad del agente para seguir operando debería disminuir.
- Deuda de verificación = 0: El agente puede continuar libremente.
- Deuda de verificación = 3: El agente debe realizar una verificación antes de emprender nuevas acciones.
- Deuda de verificación = 5: El agente se detiene por completo.
La economía de la inspección
No todos los pasos de verificación tienen por qué conllevar el mismo coste de ejecución. Los defectos «baratos» deben detectarse de forma económica mediante un proceso de inspección por niveles:
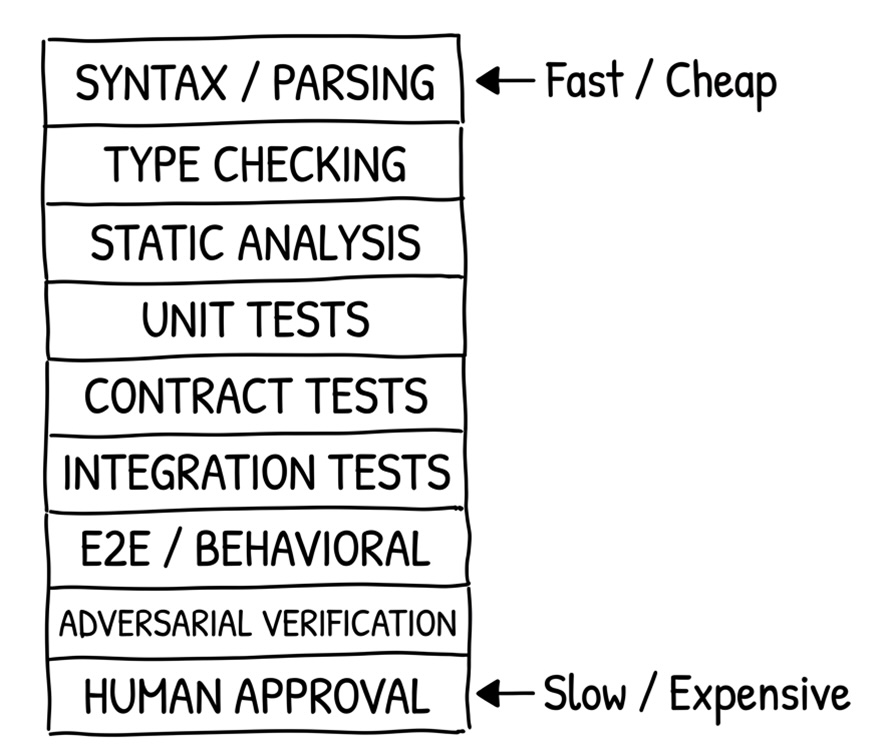
La verificación debe seguir el principio de detectar los problemas lo antes posible y al menor costo posible. Un agente que introduzca un error de sintaxis sencillo —como un paréntesis faltante o una palabra clave mal escrita— debería ser detenido en cuestión de segundos por el primer nivel de control, y no tras una larga prueba integral que ponga a prueba todo el sistema. Este mismo principio se aplica a medida que pasamos de comprobaciones más localizadas a otras más complejas y costosas que abarcan el sistema completo.
Si un agente hace referencia a una función inexistente, una prueba o verificación automatizada básica debería detectarlo de inmediato; no debería ser necesario ejecutar un conjunto de pruebas de 45 minutos que evalúe todo el sistema. En un entorno de alto rendimiento, donde un agente genera docenas de posibles cambios por hora, optimizar el propio ciclo de verificación resulta fundamental para evitar cuellos de botella a nivel sistémico.
Control de procesos y análisis de causa raíz
Control estadístico de procesos
En la manufactura tradicional, el Control Estadístico de Procesos (SPC, por sus siglas en inglés) supervisa el proceso, no solo los resultados individuales. El objetivo es distinguir un defecto aislado de un cambio en el proceso subyacente. Si la tasa de defectos de un agente aumenta repentinamente, centrarse únicamente en los fallos de pruebas individuales impide detectar cambios a nivel de sistema (por ejemplo, el truncamiento de la ventana de contexto, el deterioro de los pesos del modelo, una alteración en el comportamiento de las herramientas o especificaciones de API obsoletas).
El seguimiento de métricas a nivel de proceso proporciona visibilidad sobre el estado del sistema:
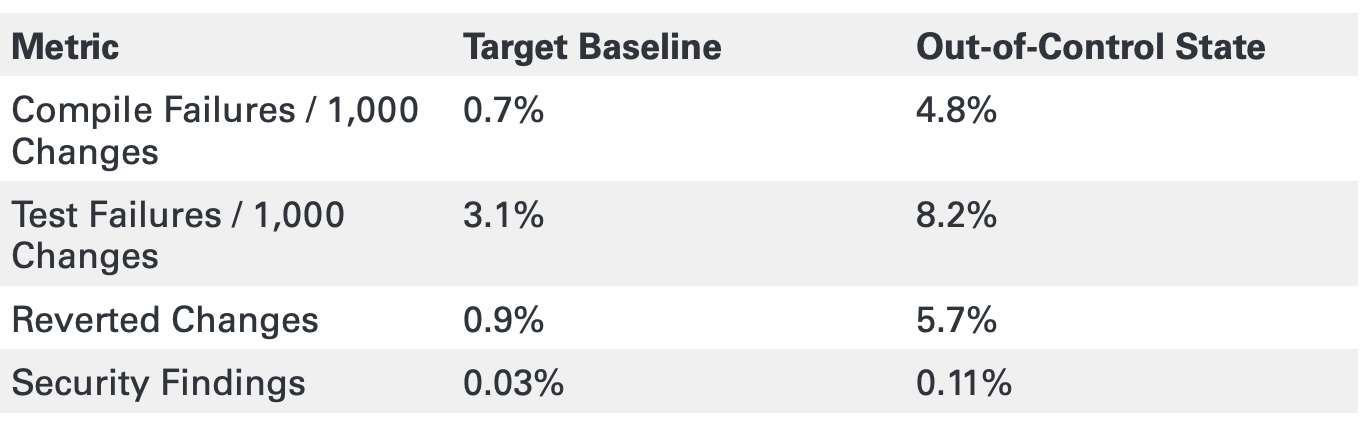
Cuando las métricas superan los umbrales de referencia, la pregunta pertinente no es «¿es malo este cambio en el código?», sino «¿se ha descontrolado el propio proceso de producción?».
La revisión humana se desplaza a un nivel superior
Cuando un ingeniero supervisa docenas de agentes autónomos, la revisión manual del código línea por línea se vuelve imposible. El rol humano evoluciona: pasa de revisar cambios individuales a evaluar la integridad del proceso de producción, lo que incluye la cobertura de verificación, los patrones de fallo, los invariantes arquitectónicos y las causas raíz.
Esto no es algo totalmente nuevo. El enfoque de Toyota, que combinaba automatización con un toque humano, permitía que una sola persona supervisara múltiples procesos, interviniendo únicamente cuando surgía alguna anomalía. Los agentes de programación pueden generar un cambio similar: los ingenieros dedican menos tiempo a producir e inspeccionar cambios individuales, y más tiempo a diseñar, supervisar y mejorar el sistema que los genera. Esto plantea una cuestión más compleja: si los agentes realizan por sí mismos una mayor parte del trabajo de mejora, ¿cómo pueden los ingenieros seguir desarrollando sus competencias?
Existe un riesgo real. Tradicionalmente, los ingenieros aprenden escribiendo código, depurando fallos y observando las consecuencias de sus decisiones. Si los agentes asumen todas estas actividades, no podemos dar por sentado que la experiencia técnica seguirá desarrollándose de forma natural a un nivel superior.
La solución no consiste en mantener a los humanos artificialmente ocupados escribiendo código. Los ingenieros deberán aprender a comprender el sistema desde otra perspectiva: definiendo qué constituye un buen resultado, identificando anomalías significativas, cuestionando las mejoras propuestas por el agente y determinando si una optimización local mejora realmente el sistema en su conjunto. Aunque los agentes se encarguen cada vez más de la ejecución técnica de las mejoras, la responsabilidad de evaluar dichas mejoras seguirá recayendo en los ingenieros.
Kaizen (Mejora continua)
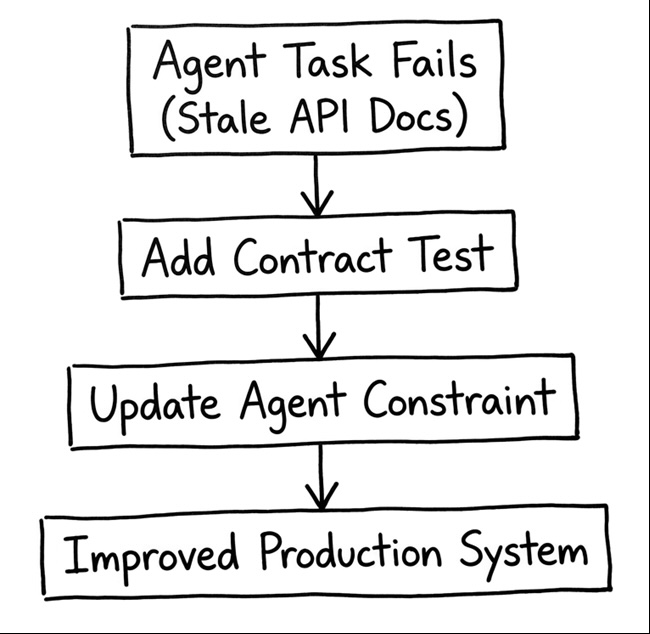
Ante un fallo, el bucle de actuación del agente debería generar conocimiento sobre el proceso, en lugar de limitarse a realizar un nuevo intento. El agente puede identificar patrones y proponer mejoras de forma progresiva; no obstante, el sistema que lo rodea debe garantizar que dichas mejoras sean validadas antes de convertirse en nuevas restricciones:
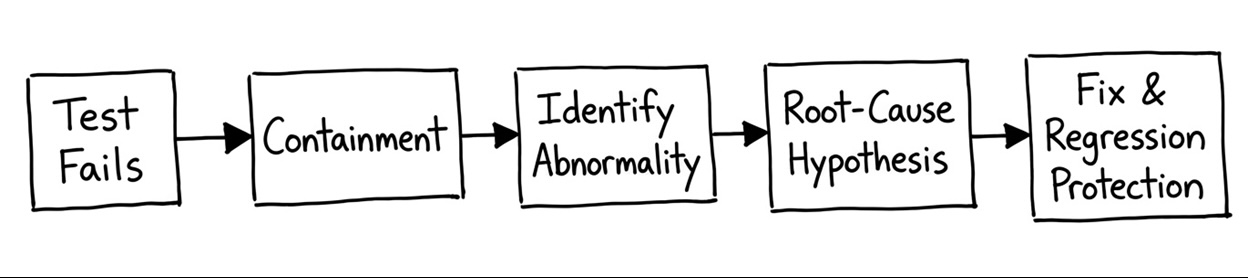
Cada fallo debería actualizar de forma permanente las restricciones del sistema:
Trazabilidad de extremo a extremo
Cuando un defecto aparece en el entorno de producción meses después de su despliegue, rastrear su origen en una base de código generada por agentes requiere una cadena de procedencia completa:
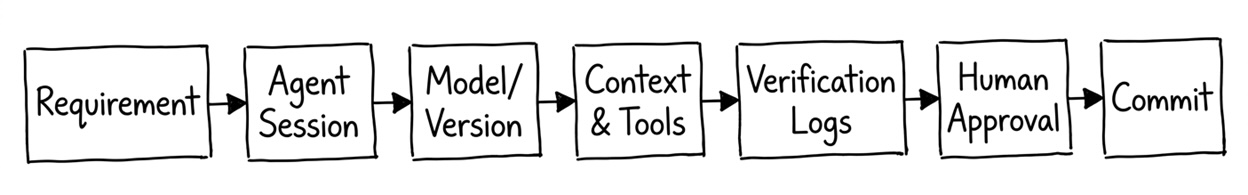
Comprender el origen de un defecto desplaza el enfoque del diagnóstico: ya no se trata de preguntar «¿Quién escribió este código?», sino «¿Qué proceso de producción generó este código y en qué punto falló dicho proceso?».
Conclusión: El sistema de calidad es el verdadero entregable
El debate en torno a los agentes de IA para la programación suele centrarse excesivamente en el agente en sí: qué modelo utiliza, qué métricas de rendimiento emplea, cuál es su ventana de contexto o qué capacidades de razonamiento posee.
Estos factores son importantes, pero el sistema que rodea al agente resulta, en última instancia, mucho más relevante. Un agente mediocre que opera dentro de un entorno de verificación excepcional superará sistemáticamente a un agente brillante que trabaja en un entorno deficiente. El futuro de la ingeniería de software autónoma no consiste tanto en crear una IA que nunca comete errores, sino en desarrollar un sistema de producción en el que los errores resulten poco costosos, estén contenidos, sean visibles y se corrijan con rapidez.
La primera oleada de desarrollo de software bajo la metodología Lean se centró en optimizar el flujo, reducir el tamaño de los lotes y acortar los ciclos de retroalimentación. La próxima evolución se centrará en la verificación. A medida que los costes de producción tienden a cero, la ingeniería de calidad se convierte en el factor limitante principal.
Pero hay otra cuestión que no debemos perder de vista. Si los agentes se encargan cada vez más de las tareas de mejora, también debemos diseñar sistemas en los que los ingenieros sigan aprendiendo. El objetivo no es eliminar la experiencia técnica del sistema de producción, sino trasladarla al nivel donde pueda generar el mayor impacto.
La pregunta más importante en el desarrollo de software moderno ya no es: «¿Cómo creamos software más rápido?».
Es: "¿Cómo construimos un sistema que genere software a gran velocidad sin permitir que, al mismo tiempo, se filtren defectos con la misma rapidez?".
Este artículo y sus gráficos han sido elaborados con la ayuda de la IA.
Remo H. Jansen. Responsable técnico en Marsh, autor, colaborador de proyectos de código abierto y conferenciante internacional, con sede en Wexford, Irlanda.Extraído de: The Lean Post
basics, Mejora continua, PeopleDevelopment
- Visto: 10